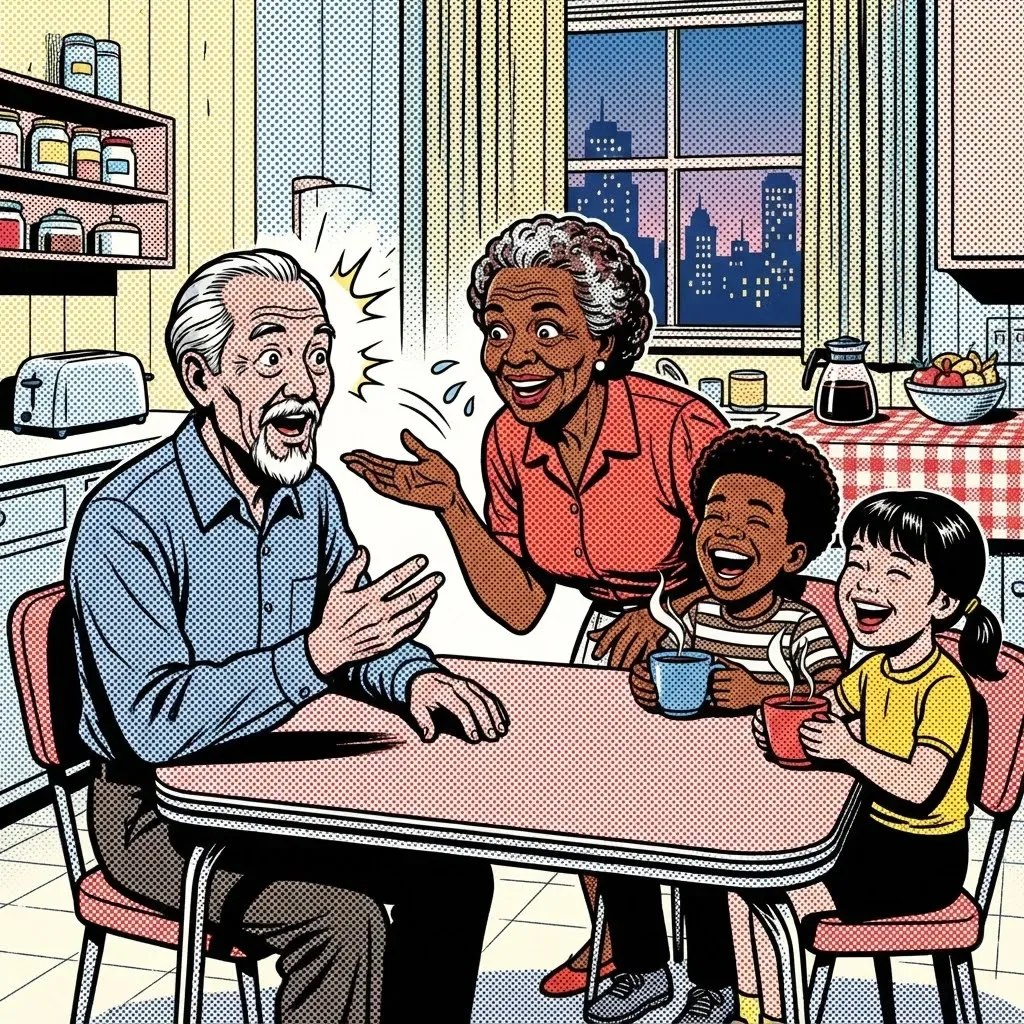
Seu Osvaldo começa a frase, e Dona Zuleide termina, depois de quarenta e poucos anos de casa. “Amanhã a gente precisa passar no...” e ela emenda: “mercado, que acabou o café”. Ela não leu a mente dele. Ouviu tanta frase começar daquele jeito, naquela hora, que a continuação aparece sozinha. Quase sempre acerta. De vez em quando erra feio, e o Osvaldo protesta: “Não, no banco!”. Os netos acham graça. Sem saber, a Dona Zuleide já mostra como um LLM funciona.
LLM vem de Large Language Model, que em português fica como modelo de linguagem de grande porte. É um programa treinado com uma quantidade enorme de texto para prever qual pedaço deve vir a seguir. Parece pouca coisa, mas, em escala grande, essa previsão dá conta de escrever, resumir, traduzir, classificar e conversar. É o motor por trás do ChatGPT, do Claude e do Gemini. Quando você escreve na caixa de conversa, é um LLM que responde, palavra por palavra.
Vale saber disso mesmo sem ser técnico. Ajuda a entender por que a ferramenta escreve tão bem e erra coisas simples, por que a resposta muda quando você troca uma palavra e por que ela não sabe o que aconteceu na semana passada.
Prever a próxima palavra, uma quantidade absurda de vezes
O modelo não lê como a gente lê. Ele quebra o texto em pedaços chamados tokens, que podem ser uma palavra inteira, parte de uma palavra ou um sinal de pontuação. “Campanha” costuma ser um token só. “Inacreditavelmente” provavelmente vira vários.
No treinamento, o modelo recebe um trecho com o final escondido e tenta adivinhar o próximo token. Erra, recebe a correção, ajusta seus parâmetros internos (milhões ou bilhões de pequenos botões de regulagem) e tenta de novo. Repete isso um número difícil de imaginar de vezes, com livros, sites, manuais, conversas e código. No fim, os botões ficam regulados para captar gramática, estilo, padrões de raciocínio e bastante informação sobre o mundo.
É como a Dona Zuleide, só que em escala industrial. Ela tem quarenta anos de ouvido para um marido. O modelo tem uma biblioteca inteira de ouvido para a escrita humana. A diferença é que ele não guarda frases prontas numa gaveta. Ele gera a continuação na hora.
As etapas da formação
Um modelo que você usa hoje não sai pronto do primeiro treino. O processo passa por fases com objetivos diferentes, e cada uma explica um traço do comportamento final. A tabela resume o caminho de forma simplificada.
| Etapa | O que acontece | O que isso explica no uso |
|---|---|---|
| Pré-treinamento | O modelo aprende a prever texto lendo um volume enorme de material | Fluência, vocabulário amplo, conhecimento geral até uma data de corte |
| Ajuste fino com instruções | Ele é treinado com exemplos de perguntas e boas respostas | Capacidade de seguir pedidos e responder em formato de conversa |
| Ajuste com avaliação humana | Pessoas comparam respostas e indicam as melhores | Tom educado, recusas em temas de risco, tendência a agradar |
| Produto final | A empresa adiciona regras, busca na web, memória e outros recursos | Diferenças entre ferramentas que usam modelos parecidos |
O que isso explica no dia a dia
Quando você sabe que o LLM prevê continuações prováveis, muita coisa estranha deixa de ser mistério.
Ele escreve bem porque aprendeu com muito texto bem escrito. Gramática, ritmo e estrutura de parágrafo são padrões abundantes, então saem com facilidade.
Ele erra fatos porque não consulta uma base conferida. Quando o fato é raro ou muito específico, a continuação provável pode soar certa sem ser. É a Dona Zuleide completando “no mercado” quando era “no banco”, só que sem o Osvaldo para protestar.
Ele muda a resposta quando o pedido muda, porque cada palavra escrita mexe nas probabilidades do que vem depois. “Escreva um texto para o cliente” e “escreva um texto curto e direto para um cliente irritado com o atraso” levam a caminhos bem diferentes. Por isso a forma de pedir pesa tanto.
Ele tem data de corte, porque o treinamento parou em algum momento. Do que aconteceu depois, só sabe se a ferramenta buscar na internet ou se você trouxer a informação.
E não lembra de você entre conversas, a menos que o produto tenha memória ligada. O modelo em si não aprende com cada papo. O que muda a resposta é o que está na conversa daquele momento.
No Estúdio Candeia, um briefing em três tentativas
O exemplo é fictício. O Estúdio Candeia é uma agência pequena que atende marcas de cosméticos. De manhã, o redator Kenji Moura recebeu um briefing longo, confuso e repetitivo, escrito pelo cliente em forma de e-mail.
Primeiro ele pediu: “resuma este briefing”. Veio um resumo correto, mas sem graça, que achatava as prioridades. Aí ele percebeu que o modelo responde ao que está escrito, então refez o pedido: “organize este briefing em objetivo, público, mensagem principal, restrições e entregáveis; marque com interrogação tudo que estiver ambíguo”. O segundo resultado foi bem mais útil. As interrogações mostraram três pontos que o cliente não tinha deixado claros.
A diretora de arte, Amara Nwosu, pegou essas três dúvidas e pediu uma sugestão de como perguntar ao cliente sem dar a impressão de que a agência não tinha lido o e-mail. Ela usou quase inteira uma das versões, trocando só a saudação.
Por fim, a gerente de projetos, Sofia Lindqvist, conferiu o resumo contra o e-mail original, linha por linha. Achou um erro: o modelo registrou o prazo como “fim do mês”, e o cliente tinha escrito “dia 25”. Pequeno, mas desses detalhes que viram problema. O LLM organizou e acelerou. Quem garantiu que o resultado batia com a realidade foi a equipe.
Experimente com IA
O modelo propõe e arruma, e quem assina o trabalho confere e decide. Antes de colar um briefing, veja se a ferramenta foi aprovada pela agência e tire dados pessoais e números confidenciais do cliente.
- “Organize o briefing abaixo em objetivo, público, mensagem principal, restrições e entregáveis. Marque com [?] cada informação ambígua ou contraditória e não preencha lacunas por conta própria: [cole o briefing].”
- “Reescreva este parágrafo de três maneiras: uma mais curta, uma mais calorosa e uma mais formal. Depois explique em uma linha o que mudou em cada versão: [cole o parágrafo].”
- “Compare o resumo com o texto original e liste qualquer data, nome ou número que aparece diferente entre os dois: [cole os dois textos].”
Leve com você
- LLM é um modelo de linguagem de grande porte que prevê o próximo pedaço de texto.
- Ele gera a resposta na hora, sem buscar frases prontas.
- Texto fluente não garante fato correto.
- Pedidos mais específicos mudam as probabilidades e melhoram o resultado.
- Tem data de corte e, sozinho, não lembra de conversas anteriores.
- Conferir datas, nomes e números é tarefa humana.
Para fechar
Deixe o modelo completar a frase, porque a velocidade e o repertório dele são úteis de verdade. Mas leia a frase inteira antes de sair correndo para o mercado, como a Dona Zuleide e o Seu Osvaldo fazem há décadas ;)
ORIGEM E CONTEXTO
Este conteúdo reúne práticas de gestão de projetos em agências e produtoras. Os exemplos são fictícios.
Conteúdo e reflexões escritas a partir da experiência do(a) autor(a).